你好,我是吴老师。
这份是给你自己读的——不用等我讲,你一段一段往下看,看到让你停下来的地方,就照着做一遍。看不懂的整段复制给 AI,加一句"请一次只解释一个概念,讲完问我一个小问题"。
读完之后,你应该能:说清麦克风和扬声器在"声↔电"上是反过来的;解释 ADC 怎么把声音变成数字;说出回声程序在搬什么;用一个数表示"这一段声音有多大"。
用时:60–90 分钟。准备:板子、数据线、已经接入板卡 Skill 的 WorkBuddy。
一、上一课的反向操作
上一课我们让板子开口:你会生成数字、送出去,扬声器就响。
这一课把它整个倒过来:让板子听见。
先做最直观的实验:对板子说一句话,它一字不差地重复给你听。这个实验叫回声(echo),就像对着山谷喊话。
动手之前先想一个反直觉的问题:说话是空气振动撞到耳朵,可板子没有耳朵,它只有数字。你说的话到了板子里,会变成什么?
——变成一堆数字。
那它是怎么把"空气振动"变成数字的?往下看。
二、先做回声实验
请使用课程的 esp32s3-touchboard-hardware-dev Skill,做一个"回声"程序:
板子从麦克风连续采声音,把采到的声音立刻从扬声器放出来,
就像对着山谷喊话一样。初始化音频时复用本课例程里 ES8311 + I2S 的初始化方式。
屏幕显示"回声中,说句话试试"。帮我新建程序并烧录。
💡 想先一步听到效果? 本页「本节演示」里的回声已经是做好的成品——点【在线烧录】一键烧进板子,先玩 30 秒;有底了再回来自己动手让 AI 写一个。
对着它说句话。你听到的自己的声音和平常不一样吧?
| 现象 | 勾选 |
|---|---|
| 声音发闷、变扁 | |
| 有呲啦杂音 | |
| 尖叫(啸叫) |
大部分人听到的自己的录音都"不像自己"。因为平时你说话,声音既从空气传到耳朵,也从骨头直接传到脑袋;录音只剩空气这一路。找同桌听,他们反而觉得像你。
三、麦克风:一面反过来工作的"鼓"
上一课扬声器是"电动的鼓":电压变 → 纸盆动 → 空气推。
麦克风刚好反过来:空气推 → 纸盆动 → 产生微弱电压。
| 扬声器 | 麦克风 | |
|---|---|---|
| 谁先动 | 电压先动,纸盆跟着动 | 纸盆先动,电压跟着产生 |
| 能量方向 | 电 → 声 | 声 → 电 |
⚠️ 比喻有边界:现在手机里那种小话筒(MEMS)没有看得见的"纸盆",但"声 → 电"的方向不变。
自己动手看一下"方向反过来"是什么意思(点上面的按钮切换):
重点看时机:扬声器是"电压先动,纸盆才动";麦克风是"纸盆先动,电压才产生"—— 同一面鼓,能量往哪边走,就决定了它是扬声器还是麦克风。
麦克风给出的电压又小又连续,可板子只会处理数字。怎么进去?——靠 ADC。
四、ADC:给电压"拍照"
第 11 课的 DAC 把数字变电压;这一课的 ADC 反过来:电压变数字。
ADC 的干活方式就是拍照:
每隔一小段固定时间,看一眼电压多大,记成一个数字。看一眼记一个,再看一眼再记一个。
- 每秒"拍"多少次 = 采样率(上次是"送"的节奏,这次是"拍"的节奏)
- 每个数字分多细 = 位深。我们用 16 位:把电压分成 65536 格,每格一个数字
整条录音链:
空气振动 → 麦克风 → 微弱电压 → ADC 按节奏拍照成数字 → 数字存起来
自己"拍"一遍(拖下面的滑杆改采样率和位深):
一定要拖这两个滑杆试试:
- 采样率调很低 → 绿点变得很稀,波形细节丢了(录音会又闷又糊);
- 位深调很低 → 点被"台阶化",波形和实际取值差很远(声音会有沙沙的量化噪声)。
这两个数字,就是录音时最常要权衡的两个东西。
五、声波的样子:上上下下的一串数
你的话变成一长串数字,画出来是波浪状:
- 起伏多快 = 频率 → 音调
- 起伏多高 = 振幅 → 响度(音量)
- 起伏什么形状 = 波形 → 音色
音量在程序里 = 这些数字离开中间 0 有多远。 数字都贴着 0 → 安静;数字冲很高 → 响。
切换三种场景,看"音量"这个数怎么跟着变:
注意两件事:
- 安静不是 0 —— 世界上没有绝对的安静,麦克风总能测到一点底噪,所以安静时是几十,不是零;
- 柱子是平滑变化的 —— 不是每 0.1 秒猛跳一下。"响"在程序里不是感觉,是数字。
六、回声在搬什么
回声程序的中文伪代码:
不断重复:
    从麦克风读一串数字
    把这一串数字原样送出去
读进来什么样,送出去就什么样——板子并不"理解"你的话,它只是忠实地把数字搬了个家。让板子听懂话(语音识别),是以后联网课程的事。
七、让屏幕看见声音:音量柱
怎么用一个数代表"这段声音多大"?
简单办法:把 0.1 秒内所有采样(1600 个)的绝对值加起来除以个数 → 平均音量。
请做一个"音量指示器":
麦克风每 0.1 秒算一次平均音量,
屏幕左边画一根柱子,音量越大柱子越高(超过安全值变红),
上面实时显示音量数值。柱子要平滑变化,不要乱跳。
然后测三个场景:
| 场景 | 我预测 | 实际 |
|---|---|---|
| 安静 | ||
| 正常说话 | ||
| 喊 |
"响"在程序里不是感觉,是数字。 安静时几十,说话时几百上千,喊叫更高。
八、啸叫是什么
板子靠近扬声器,可能听到刺耳尖叫——啸叫。
声音链:扬声器放出 → 麦克风收进 → 放大 → 再放出……绕圈变大,变成尖叫。
| 我做的操作 | 看到/听到 |
|---|---|
| 板子靠近喇叭 | |
| 移开 |
这不是故障,是"回声变成循环"。电话会议、演唱会都怕它。你能想一个简单的压制办法吗?(提示:声音已经很大时,别急着放大。)
九、没声音排查
| 现象 | 先检查 |
|---|---|
| 回声没声音 | 串口报初始化失败了吗?麦克风方向对吗? |
| 声音很轻 | 调大音量 |
| 全是嘶嘶底噪 | 去安静环境;看缓冲大小 |
| 一冲一冲 | 读和放是不是互相堵死了 |
十、拓展:把声音画成彩色瀑布 ⭐
前面我们把 0.1 秒的声音压成了一个数(音量)。可这样也太浪费了——那 1600 个数字里,明明还藏着"这句话是低音还是高音、有没有吹口哨"的信息。
想把它们挖出来,就要用到 FFT(快速傅里叶变换)。
先理解它在干什么
想象一锅汤:你尝一口,只知道"咸"。这就像音量——把整段声音压成一个数。
FFT 干的是另一件事:把这段声音拆开,告诉你里面有多少"低音成分"、多少"中音"、多少"高音"。
打拍子类比更准一点:任何一段声音,都可以看成很多个不同音高的纯音叠在一起。FFT 就是把这段声音拆回那些纯音,然后告诉你每个音高各占多大声。
拆完之后我们得到一排数字:第 1 格是 62.5 Hz 有多大,第 2 格是 125 Hz 有多大……一直到第 128 格。
把这一排数字画出来
横轴 = 频率(左边低音、右边高音),颜色 = 强度(越红越响)。画成一排竖直的柱子。
然后让画面往下流:每隔 64 毫秒画一排新的,旧的被挤下去。竖轴就变成了时间。
这叫做瀑布图——像瀑布一样,新的在最上面,一层层往下流。
动手做
请使用课程的 esp32s3-touchboard-hardware-dev Skill,做一个"频谱瀑布流":
麦克风以 16kHz 采样,攒够 1024 个采样(64 毫秒)做一次 256 点 FFT,
把 120 个频段画成彩色竖条,让画面一行一行往下流动成瀑布。
横轴是频率(左边低音右边高音),颜色表示强度(黑→蓝→青→绿→黄→红)。
屏幕用 sprite 画(大缓冲放 PSRAM),并接入 ScreenMirror 方便抓帧。
五种声音,五种图案
这是本课最好玩的部分。对着板子做下面五件事,把看到的形状记下来:
| 你做什么 | 瀑布上出现什么 | 为什么 |
|---|---|---|
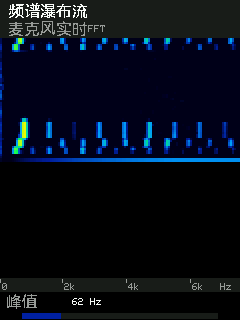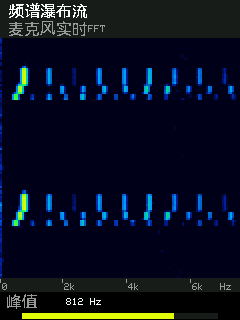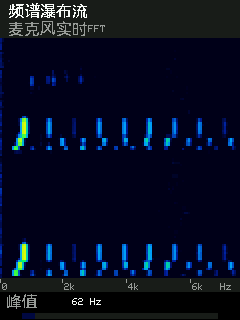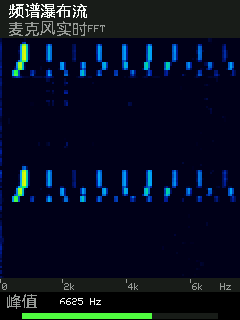
| 安静不说话 | 整片偏暗,只有最左边一点底噪 | 没有声音,只剩电路自己的噪声 |
| 说一句话 | 左边一片上下跳动的亮色 | 人声能量集中在低中频;说话时音高在变,所以亮块在动 |
| 吹口哨 | 一根又直又亮的细柱 | 口哨几乎是单一频率——这是最漂亮的一张图 |
| 拍手 / 敲桌子 | 一瞬间整排都亮(一条横线) | 拍手是"宽频"冲击,所有频率同时有能量 |
| 唱「啊」再升高音 | 亮柱整体向右移动 | 升高音 = 频率变高 = 往右边走 |
💡 吹口哨那一根柱,就是 FFT 最直观的证据:它真的把"一个频率"从声音里挑出来了。
按一下 BOOT 试试
短按板子上的 BOOT 键,会响三声轻柔的音(C5→E5→G5)。
这三声从扬声器放出来,立刻被麦克风收回去——瀑布上会出现三条竖直的亮柱。
这是"声音看得见"最直接的证据,也能顺便检查麦克风是不是好的。
两个你可能想问的
为什么右边经常是黑的?
因为自然界的声音能量大多集中在低频。你说话时高频部分本来就弱得多,直接画出来右半屏几乎全黑、什么都看不见。
所以程序里加了个高频补偿:按每倍频程 +4.5 dB 放大高频。就像调音响的"高音旋钮"——不改变横轴"左低右高"的真实对应,只是让细节看得见。所有的频谱仪都这么干。
为什么一帧要算 4 次 FFT 再平均?
单次 FFT 得到的数字很"毛躁",画面会一直闪。算 4 次取平均就稳多了——这和上一节音量柱加平滑是同一个思路。
还能怎么玩
| 想法 | 怎么做 |
|---|---|
| 声音指纹 | 对比钢琴不同音、不同人说话,瀑布图案差在哪 |
| 谁在说话 | 用图案区分男声女声、大人小孩 |
| 噪音地图 | 记录一天里教室什么时候最吵(配合 TF 卡) |
| 音乐可视化 | 放歌,让瀑布的颜色跟着节奏变 |
🔗 这里连上了第 24 课:语音识别(ASR)的第一步,就是把声音变成这样一张频谱图,再交给 AI 去认。今天你是用眼睛看,AI 是用"眼睛"看同一张图。
十一、自检小测
先自己想,再点开对答案。
1. 麦克风和扬声器,在"声↔电"方向上的关系是什么?
正好反过来。
- 扬声器:电 → 声(电压推纸盆,把空气推出一层层波)
- 麦克风:声 → 电(空气推它的膜片,产生微弱的电压变化)
一个"把电变成声音",一个"把声音变成电"——第 11 课和这一课,是同一个过程倒过来走。
2. ADC 是干什么的?和 DAC 什么关系?
ADC = 模数转换器:把电压变成数字。 它和 DAC 正好相反:
| 方向 | 在哪 | |
|---|---|---|
| DAC(第 11 课) | 数字 → 电压 | ES8311 |
| ADC(这一课) | 电压 → 数字 | ES8311 |
一颗 ES8311 就同时干这两件事,所以它叫"编解码芯片"(codec)。
3. 采样率和位深各决定什么?用"拍照"怎么解释?
ADC 干活就像给电压拍照:
- 采样率 = 每秒拍几张(16000 = 每秒拍 16000 张) → 拍得少,波形细节丢了,录回来又闷又糊。
- 位深 = 每张照片的颜色分多少级(16 位 = 把电压分成 65536 格) → 分得少,点被"台阶化",声音有沙沙的量化噪声。
采样率管"多勤",位深管"多细"。
4. 回声程序在搬什么?板子理解你说的话吗?
搬的是数字。
麦克风收到声音 → ADC 拍成数字 → 原样送出去给扬声器。
板子完全不理解你说的话——它只是把一串数字从进口搬到出口,一个都不改。 理解内容需要语音识别(那是第 24 课的事)。
5. "音量"在程序里到底是什么?怎么算出来?
音量 = 这些数字离开中间的 0 有多远。
- 数字都贴着 0 → 安静
- 数字冲得很高(或很低)→ 响
所以算音量,就是看取到的这一段数字偏离 0 的程度(取绝对值、求平均)。
6. 为什么把麦克风和喇叭凑太近会"啸叫"?
因为形成了一个循环:
喇叭发出声音 → 麦克风又收到 → 送进喇叭放大 → 再发出来 → 麦克风又收到 …
每一圈都放大一点,很快就变成刺耳的尖叫。
所以录音/放音时别把板子凑太近,也别把音量开太大。
十二、还能玩什么
| 方向 | 想法 |
|---|---|
| 噪音报警器 | 音量超阈值屏幕变红 + 灯亮 |
| 拍手开关灯 | 拍一下亮、再拍灭(要区分一次和两次) |
| 吹气游戏 | 吹气让屏幕上的球飞起来 |
| 神秘低语 | 回声 + 上一课变调,变机器人音 |
想做"板子听得懂人话"?那叫语音识别,等学了网络再回来。今天先把"收数字"练熟——下一课我们要打开盖子,看这些数字是怎么在两根线之间跑起来的。